中安OCR:红头文件数字化,不止“看得准”更要“还原真”
2026-01-16在政企办公数字化转型的浪潮中,红头文件、正式公文作为核心业务载体,其数字化处理始终面临“高要求”与“高难度”的双重挑战。这类文件格式严谨、版式规范,小到字体字号、行距边距,大到红头标识、印章位置,都有严格标准;而实际处理中,扫描件的倾斜、背景阴影、红章干扰、纸张褶皱等问题频发,传统OCR技术往往只能做到“勉强识别文字”,却难以还原原始版式,导致识别结果需反复人工修正,既耗时耗力,又易出现疏漏,拖累整体办公效率。
针对公文、红头文件的专属场景痛点,中安OCR识别系统精准破局,以“场景化定制+全链路优化”,实现从“看得准”到“精准还原”的跨越式升级,重新定义公文数字化的高效标准。
相较于通用OCR系统对公文场景的适配不足,中安OCR深度贴合《党政机关公文格式》等国家标准,将技术优化聚焦于公文处理的核心难点。面对扫描件常见的倾斜问题,系统搭载智能几何校正算法,可自动识别文档角度并完成精准校正,校正精度达细微级别,确保文字排版与原始文档完全对齐;针对背景阴影、纸张污渍及红章遮挡等干扰因素,通过自适应背景过滤与红章智能分离技术,精准剔除冗余干扰元素,同时保留红章、落款等关键标识的位置信息,既不影响文字识别精度,又能还原公文的合规性版式。更有智能漂白功能加持,对模糊、低对比度的公文扫描件进行画质增强,让淡色文字、细小标注都清晰可辨,从源头提升识别准确性。
真正的公文数字化,不仅需要文字识别无误,更需要版式结构的精准复刻。中安OCR凭借强大的版面智能分析能力,可自动解析红头标识、标题层级、正文段落、页眉页脚、页码落款等核心版式要素,依据公文逻辑关系完成结构化重组。无论是多栏排版、图文混排的复杂公文,还是跨页表格、批注标注的特殊文件,都能完美还原原始版式的排版逻辑与格式细节,实现“识别即可用”,彻底告别人工逐页调整版式的繁琐工作。
在实际办公场景中,识别结果的复用性直接影响工作效率。中安OCR充分考虑政企多场景需求,支持识别结果导出Word、Excel、PDF、OFD、TXT、Markdown等多种主流格式。无需二次转换,即可直接用于公文编辑、数据统计、档案归档、线上流转等不同场景,适配政企内部OA系统、档案管理平台等各类办公工具,实现公文数字化全流程闭环,大幅提升业务流转效率。
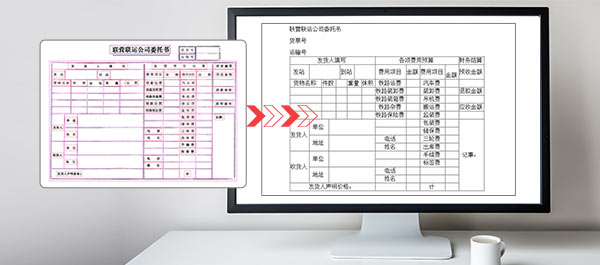
从政务机关的公文收发、档案数字化归档,到企事业单位的合同审批、红头文件留存,中安OCR识别系统以精准、高效、便捷的核心优势,成为政企数字化转型的得力助手。它不仅解放了人力从繁琐的文字录入、版式调整中脱离,将原本数小时的公文处理工作缩短至分钟级,更以高达99%以上的识别精度与版式还原度,有效规避人工操作误差,保障公文数字化的准确性与合规性。
数字化时代,办公效率的差距,藏在每一份公文的处理细节里。中安OCR识别系统,以场景化技术创新破解红头文件数字化难题,让公文处理告别“识别不准、版式混乱、复用低效”的困境,实现从纸质到电子的精准转化、高效流转。选择中安OCR,不止是选择一款识别工具,更是选择一种高效、合规、智能的公文数字化解决方案,为政企办公赋能增效,加速数字化转型进程。