从纸质到智能:OCR 文字识别系统重塑档案数字化管理格局
2025-09-26OCR(Optical Character Recognition,光学字符识别)文字识别系统,是一种能够将图像中的文字信息转化为可编辑、可搜索的电子文本的技术。在大量数据档案的管理与数字化场景中,该系统展现出了强大的应用能力。其工作流程清晰高效,首先通过专业的扫描设备对企业、图书馆或军政机构的纸质档案进行高精度扫描,将纸质文件转化为图像格式;随后,OCR 文字识别系统对扫描得到的图像进行智能处理,包括图像预处理(如去除噪声、纠正倾斜、调整对比度等)、文字定位与分割、字符识别等一系列步骤,精准提取图像中的文字信息;最后,根据用户的实际需求,系统可导出多种常用格式的文件,如双层 PDF、TXT、WORD、XML、XLS 等。
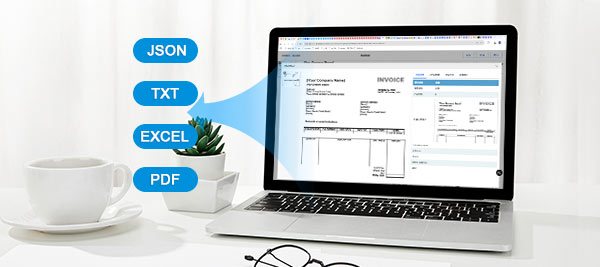
这些丰富的输出格式为档案信息的后续应用带来了极大的便利。双层 PDF 文件既保留了原始档案的图像原貌,又在图像下方叠加了可搜索、可复制的文字层,用户在查看档案原始样式的同时,能够快速检索特定文字内容,大幅提升了档案查找的效率;TXT 格式文件则以纯文本形式呈现档案内容,便于快速读取和简单编辑;WORD 格式文件为档案信息的深度编辑提供了可能,用户可根据需求对档案内容进行修改、排版;XML 格式文件则有利于档案数据的标准化存储和交换,方便不同系统之间的数据共享;XLS 格式文件则适用于包含大量表格数据的档案,便于进行数据统计、分析和计算。
凭借其强大的功能,OCR 文字识别系统在多个领域的档案数字化项目中得到了广泛应用,并取得了显著成效。在图书馆数字化项目中,图书馆拥有海量的古籍、图书、期刊等纸质文献,通过 OCR 文字识别系统对这些文献进行扫描和识别,将其转化为数字化档案,不仅实现了古籍文献的永久保存和有效保护,避免了因频繁翻阅造成的损坏,还为读者提供了便捷的线上检索和阅读服务,读者可通过图书馆的数字平台快速查找所需文献,打破了时间和空间的限制,极大地提升了图书馆的服务质量和文献资源的利用率。
在历史档案数字化领域,历史档案承载着珍贵的历史信息,是研究历史、传承文化的重要依据。然而,许多历史档案因年代久远,存在纸张老化、字迹模糊等问题,传统的管理方式难以对其进行有效保护和利用。OCR 文字识别系统能够对这些历史档案进行高精度扫描和识别,即使是字迹模糊的档案,也能通过先进的图像处理和识别算法,尽可能提取其中的文字信息,将其转化为清晰、可编辑的数字化档案。数字化后的历史档案不仅便于长期保存和备份,还能通过数字化平台向公众开放,让更多人能够接触和了解历史,助力历史文化的传承与弘扬。