复杂环境也能精准识别?中安未来国产化 OCR,全场景适配更省心
2025-11-18在企业数字化升级的进程中,“识别什么”“识别得准不准”“能否适配国产化” 成为众多企业选择OCR系统时最关心的三大核心问题。中安未来OCR识别系统凭借自主研发的硬核技术与全场景适配能力,给出了让行业满意的答案,成为各领域数字化转型的首选伙伴。
疑问一:支持识别哪些内容?全场景覆盖,无死角适配
中安未来OCR系统的识别范围堪称 “全能型”,从语言形态到文档类型,全面满足企业多样化需求。在语言支持上,打破了文字与形态的双重限制:不仅覆盖中文、英文、阿拉伯文等多国主流及小众语种,轻松应对跨境业务中的多语言文档处理;更实现了手写文字与印刷文字的双重高精度识别 —— 无论是工整的印刷合同、繁杂的财务报表,还是潦草的手写笔记、签名,都能精准捕捉核心信息,无需担心文字形态带来的识别障碍。
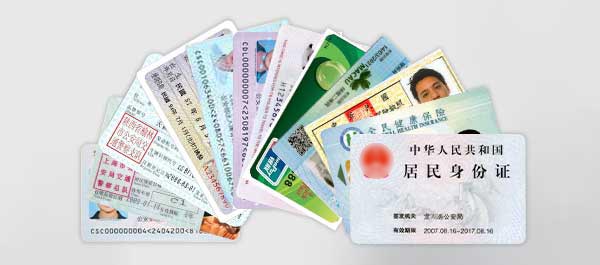
在文档类型上,系统构建了全品类识别矩阵:证件类(身份证、护照、驾驶证等)、票据类(发票、汇票、报销单等)、财务类(记账凭证、银行对账单等)、车辆类(行驶证、登记证等)、企业证照类(营业执照、组织机构代码证等)、合同文档类(商务合同、法律文书、医疗病历等),涵盖企业运营全流程中的核心文档类型,真正实现 “一种系统,全场景适配”。
更值得一提的是,系统具备强大的版面分析与数据抽取功能,无需人工干预,即可自动识别文档结构、区分关键信息与冗余内容,快速提取姓名、金额、日期、证件号等核心数据,直接对接业务系统,彻底告别 “识别 - 录入 - 核对” 的繁琐流程。
疑问二:识别效果如何?复杂环境下,精度效率双在线
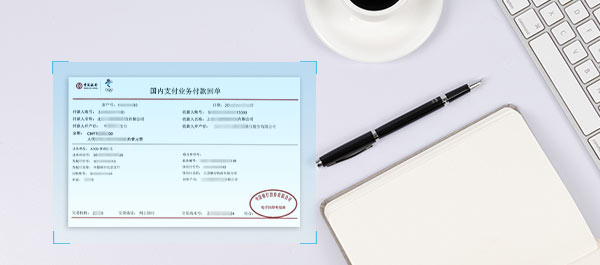
识别效果的核心是 “精度” 与 “适应性”,中安未来OCR系统凭借自主研发的核心算法,给出了行业领先的答案。针对企业实际应用中常见的文档模糊、倾斜、褶皱、阴影干扰、字迹潦草、多语言混杂等复杂场景,系统具备超强抗干扰能力,能够通过智能版面分析、字符增强、上下文语义校验等技术,精准识别关键信息,识别准确率稳居行业前列。
无论是银行柜台的身份证快速核验、保险公司的海量理赔票据录入,还是医疗行业的病历数字化归档、企业的合同条款提取,系统都能保持高效识别速度 —— 单页文档识别仅需毫秒级响应,批量处理效率较人工提升数十倍,同时避免了人工录入的疲劳误差,实现 “高精度 + 高效率” 双重保障,让企业数据处理既准又快。
疑问三:支持国产化系统吗?全栈适配,部署更省心
国产化适配是当前企业数字化转型的重要需求,中安未来OCR系统早已完成全栈国产化适配,完美支持国产CPU(如鲲鹏、飞腾)、国产GPU及国产操作系统,无需依赖进口硬件与软件环境,不仅降低了企业部署成本,更保障了数据安全与系统自主可控。
同时,系统采用轻量化部署设计,支持云端、私有化、边缘端等多种部署方式,无需大规模改造企业现有 IT 架构,即可快速集成上线,适配不同规模企业的需求。无论是大型集团的规模化部署,还是中小企业的轻量化应用,都能实现 “即插即用”,节省部署资源与时间成本,让企业轻松拥抱国产化智能识别方案。
从银行、保险、医疗到政务、企业办公,中安未来OCR系统以 “全场景识别、高精度适配、国产化支持” 三大核心优势,成为各行业数字化转型的 “得力助手”。如果您还在为 “识别内容不全、识别精度不高、国产化适配难” 等问题困扰,中安未来 OCR 系统将为您提供一站式智能识别解决方案,让数字化转型更高效、更安全、更省心!