解锁文档处理新范式|中安未来OCR SDK,一站式搞定多场景文字识别需求
2026-03-06在数字化转型加速推进的今天,企业与机构面临的文档处理场景日益复杂:跨境业务中的多语言单据识别、档案数字化中的水印干扰、扫描件的弯曲倾斜难题、多格式导出的兼容性困扰……这些痛点不仅耗费大量人力成本,更拖慢了数字化进程。中安未来深耕OCR技术领域,推出功能全面的全球语言OCR SDK,以“全语种识别+智能处理+灵活部署”的核心优势,破解文档处理全流程难题,赋能千行百业高效办公。
多语种全覆盖,打破跨境沟通壁垒。全球化业务场景中,多语言文档识别是核心刚需,传统OCR工具往往局限于主流语言,难以满足多元化需求。中安未来OCR SDK全面覆盖全球十余种核心语言及文字体系,不仅支持中文简繁体、英文、日文、韩文等常用语种,更涵盖法文、俄文、西班牙文、阿拉伯文、乌尔都语、格鲁吉亚文等小众语种,精准适配跨境贸易、涉外法务、多语种档案整理等场景。依托优化的深度学习模型,无论是清晰的印刷体文档,还是复杂背景、轻度模糊的外文单据,都能实现高精度识别,无需切换多套工具,一套SDK即可完成全语种文字提取,大幅降低跨语言沟通成本,让业务无边界拓展。
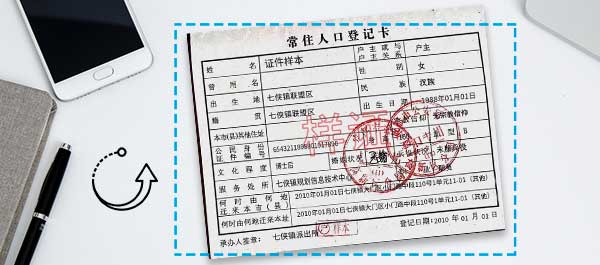
无损去水印+智能矫正,还原文档本真质感。日常工作中,扫描件、图片素材常被日期戳、企业Logo、文字水印等干扰,既影响视觉效果,也降低识别准确率;而手机拍摄、书本弯曲、扫描仪倾斜导致的文档形变,更是让传统OCR识别频频出错。中安未来OCR SDK针对性解决两大痛点,搭载智能图像修复引擎,可自动检测并擦除图片中各类水印,高保真处理确保无痕还原素材原貌,无锯齿、无模糊、无残留,让“带水印不可用”的素材重新发挥价值。同时,内置几何矫正模块,可智能完成倾斜、透视、弯曲文档的矫正,自动定位文档边缘、切除多余背景,即便褶皱卷宗、古籍书页也能一键展平,为高精度识别奠定坚实基础。
多格式自由导出,适配全场景应用需求。识别完成只是第一步,能直接对接业务场景才是核心价值。中安未来OCR SDK支持多格式快速导出,涵盖双层PDF、OFD、Txt、Excel、Word、Markdown等主流格式,满足不同业务场景的差异化需求。双层PDF保留原图与可检索文字,是档案归档的首选;OFD适配国产合规格式,完美契合政务与公文处理场景;Excel可实现表格数据自动结构化,大幅提升财务票据、报表的处理效率;Word、Txt则方便二次编辑排版,Markdown适配在线文档与知识库搭建,一次识别即可多场景复用,无需重复转换格式,显著提升文档流转效率。
灵活部署省成本,适配多元应用场景。不同企业的IT架构与成本预算存在差异,中安未来OCR SDK提供CPU与GPU双模式部署方案,兼顾高效性与经济性。CPU部署轻量便捷、成本可控,适合中小规模企业与常规办公场景;GPU部署高速高效、支持高并发,适配档案数字化中心、高吞吐业务平台等大规模应用场景。SDK接口简洁稳定,可快速集成到自有系统、移动端App、桌面软件中,兼容性强且运维便捷,广泛应用于档案数字化管理、智慧办公、金融单证处理、跨境贸易等领域,助力企业以更低成本实现文档智能化升级。
从传统人工录入到智能高效处理,从单一语种识别到全语种覆盖,中安未来OCR SDK以全链路核心能力,重构文档处理流程。无论是解决日常办公的琐碎难题,还是支撑企业数字化转型的核心需求,它都能以精准、高效、灵活的表现,将每一份文档转化为可检索、可编辑、可利用的数字资产。选择中安未来OCR SDK,解锁文档处理新效率,让数字化办公更简单、更高效!