解析证件OCR识别的核心技术与应用逻辑
2026-08-07证件OCR识别是当下政务、金融、出行等领域高频应用的智能识别技术,核心是依托人工智能算法模拟人类视觉认知逻辑,实现各类证件图像文本的全自动、高精度提取与结构化处理。相较于传统人工录入和老旧识别技术,证件OCR识别具备全字段识别、高适配、低误差的优势,彻底解决了证件信息录入效率低、易错漏的行业痛点,成为数字化信息采集的核心工具。整套技术流程层层递进,分为图像预处理、文本检测定位、字符识别与结构化输出三大核心阶段,共同构建起精准高效的智能识别体系。
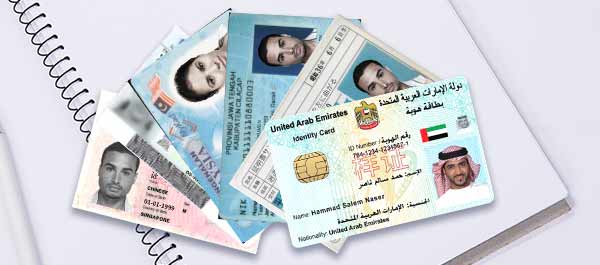
图像预处理是证件OCR识别的基础前提,直接决定后续识别的成功率与精准度。在实际拍摄、扫描场景中,身份证、驾驶证、护照等证件图像极易出现反光、阴影、模糊、倾斜、底纹干扰等问题,严重影响文本识别效果。针对各类图像瑕疵,技术系统集成了成熟的优化算法,通过去噪处理剔除画面杂点,利用二值化强化文本与背景的对比度,依托Canny算子完成边缘检测与倾斜校正,让歪斜的证件画面自动规整对齐。同时通过灰度微调、光影优化等手段,消除反光和阴影干扰,最大化凸显文本区域,为后续精准检测定位筑牢基础。
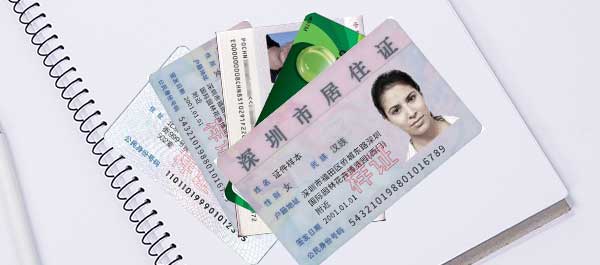
文本检测与定位是证件OCR识别的核心关键,实现了从“图像优化”到“精准找字”的过渡。传统OCR技术仅能识别少量固定字段,存在信息遗漏、适配性差的弊端。而现代化证件OCR识别搭载YOLOv8、Faster R-CNN等先进目标检测模型,可全域扫描证件图像,精准捕捉所有文本字段的边界坐标。无论是身份证的姓名、证件号、有效期,还是护照、驾驶证的各类细分字段,系统均可全方位定位,兼顾核心字段与次要细节,彻底规避信息遗漏问题,为字符识别划定精准的目标范围。
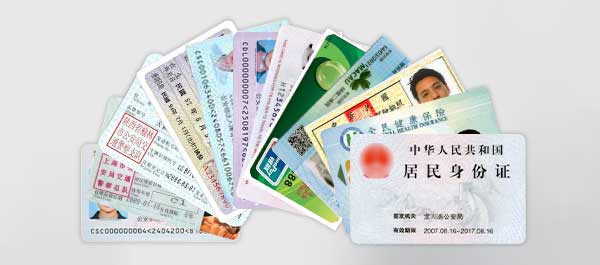
字符识别与结构化输出是证件OCR识别的最终落地环节,实现图像信息到可用数据的转化。该环节采用CRNN卷积循环神经网络、Transformer架构等前沿AI模型,可适配不同字体、字号、繁异体字符的识别场景,兼容各类版式复杂的证件。同时搭配正则表达式规则引擎,对输出信息进行格式校验,严格匹配身份证号、护照号码等专属编码规则,自动筛查、标记异常错误数据。整套技术流程形成闭环,兼具效率与准确率,为各行业证件信息数字化录入、智能核验提供了坚实的技术支撑。
作者:中安未来